Docker y Podbag con 30 pods web en k3s
por 
 @SteelCrabel en Rendimiento, IngenieríaEnlace permanente
¿Cuánto tarda la aplicación en estar lista? ¿Qué cambia cuando ya atiende solicitudes? Ejecutamos la misma aplicación en un nodo k3s con dos motores de contenedores.
Qué medimos
Seis pods web envían solicitudes a 24 pods de API mediante un Service de Kubernetes. Cada API responde con el nombre de su pod. Un cliente en el nodo llama a la ClusterIP del servicio web. Contamos como éxito un estado 200 con el nombre de un pod de API en el cuerpo.
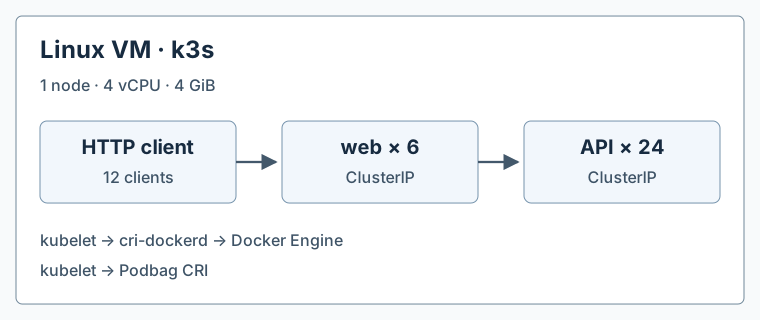
Ambas capas usan la misma imagen de NGINX y sondas HTTP de disponibilidad. Cada contenedor solicita 20m de CPU y 16 MiB de memoria, con límites de 200m y 48 MiB. K3s usa su adaptador cri-dockerd para Docker Engine y el socket CRI de Podbag para este último.
Ubuntu 26.04.1 LTS · Linux 7.0.0-43-generic · ARM64 · 4 vCPU · 4 GiB · k3s v1.37.2+k3s1 · Docker Engine 29.1.3 · Podbag c0ff5eb
Resultados
Tabla de mediciones
| Métrica | Docker Engine | Podbag |
|---|---|---|
| Los 30 pods listos | 3,39 s | 2,48 s |
| HTTP p95 con carga fija | 1,41 ms | 1,26 ms |
| HTTP p95 en ráfaga | 3,46 ms | 3,69 ms |
| Respuestas correctas/s en ráfaga | 7.019 | 6.330 |
| Respuestas validadas | 33.600 / 33.600 | 33.600 / 33.600 |
En este nodo, la mediana del despliegue fue 0,91 s menor con Podbag. A 240 solicitudes/s, el p95 por ronda fue 1,20–1,60 ms con Docker y 0,93–1,88 ms con Podbag. Los 24 pods de API respondieron en todas las rondas. En la ráfaga, Docker tuvo la mayor mediana de solicitudes por segundo. Los rangos por ronda se solaparon.
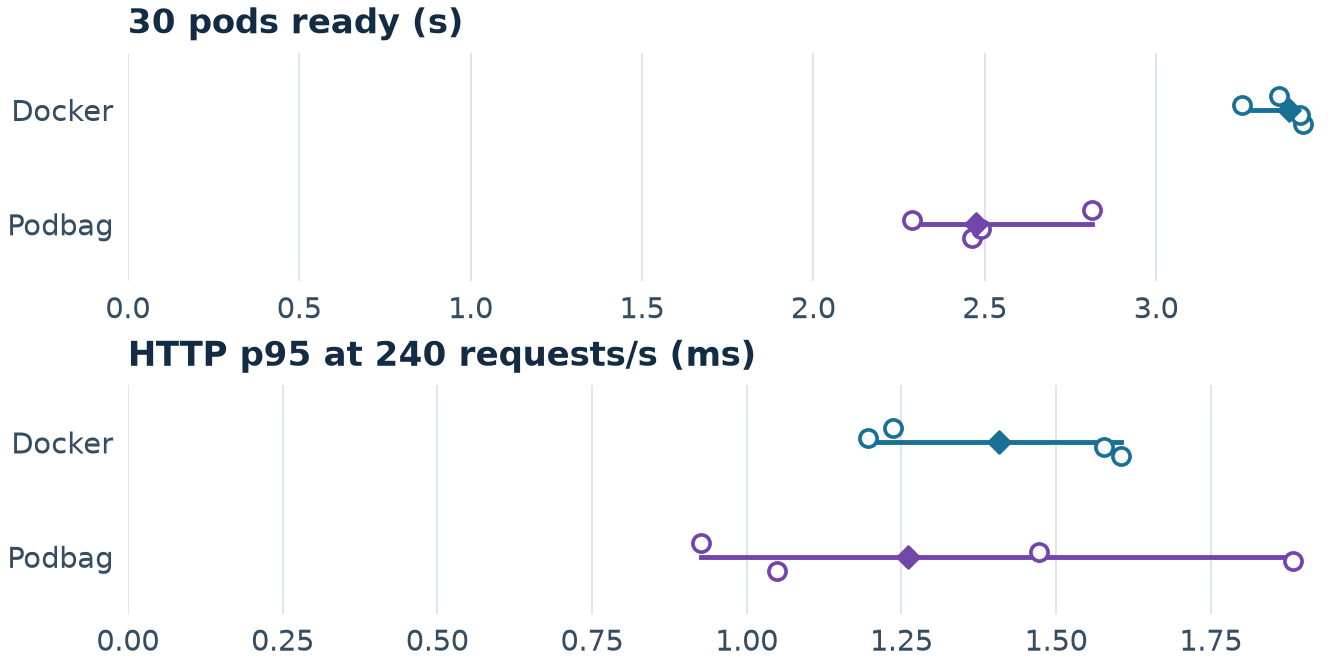
El cronómetro empieza justo antes de la primera solicitud de escalado. Consultamos los dos Deployments cada 100 ms hasta que informan de 30 réplicas listas. Verificamos los 30 endpoints y esperamos dos segundos. Doce clientes envían 100 solicitudes cada uno con conexiones TCP nuevas. El p95 es el tiempo en el que termina el 95 % de las solicitudes correctas.
Tras la ráfaga esperamos dos segundos. Los mismos doce clientes enviaron 20 solicitudes por segundo cada uno durante unos 30 segundos, con un objetivo total de 240 por segundo. Calculamos el p95 de cada fase por separado.
El orden fue Docker → Podbag → Podbag → Docker. Cada bloque incluyó un calentamiento y dos rondas medidas. La tabla muestra la mediana de cuatro rondas por motor y la suma de respuestas correctas. Las imágenes estaban en caché. El cliente compartía las CPU de la máquina virtual. La API devolvía texto breve. La prueba no incluye consultas a bases de datos ni latencia de redes externas.
Los resultados describen un despliegue y un servicio HTTP en un nodo. El cliente y la red influyen en la tasa de la ráfaga. Su corta duración impide estimar el rendimiento máximo sostenido.
Por qué importa la referencia de la imagen
En la prueba preliminar usamos el índice multiarquitectura de NGINX con IfNotPresent. Podbag tenía la imagen ARM64, pero la consulta CRI por el digest del índice no la encontró. El kubelet reintentó la descarga y alcanzó el límite de solicitudes. Para medir, verificamos el digest del manifiesto ARM64 en ambos motores y usamos imagePullPolicy: Never. Reiniciamos la máquina virtual y creamos un clúster nuevo para cada bloque.
Ejemplo de despliegue en AWS
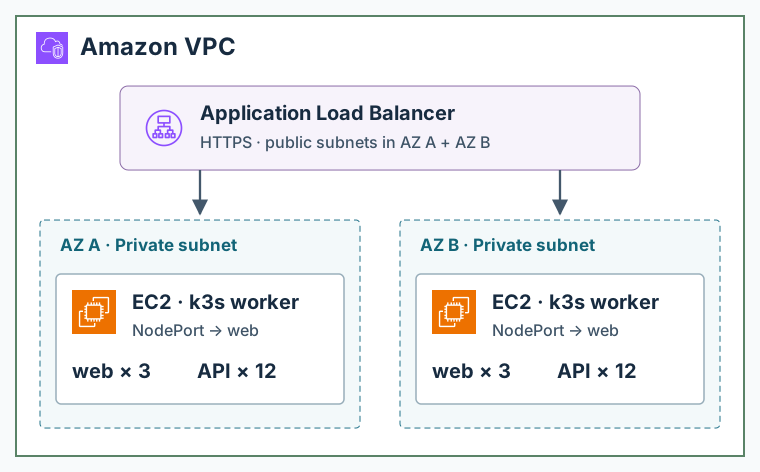
Un Application Load Balancer público utiliza subredes públicas de dos zonas de disponibilidad. Envía el tráfico HTTPS al NodePort del servicio web en nodos EC2 de subredes privadas. Para colocar tres réplicas web y doce de API por zona, configure restricciones de distribución por zona para cada Deployment. La API conserva un Service interno de tipo ClusterIP. La figura muestra la ruta del tráfico de la aplicación.
AWS Application Load Balancer · AWS Architecture Icons
Cómo repetir la prueba
Carga de trabajo · Programa de medición · Datos de cada ronda · Configuración del nodo y orden de ejecución · start-node.sh