在 k3s 上运行 30 个 Web Pod:Docker 与 Podbag 实测
作者:
 @SteelCrab发布于 分类:基准测试, 开发永久链接
部署后需要多久才能接收请求?服务就绪后,运行时还会影响响应速度吗?我们在同一台 k3s 节点上切换运行时,分别测量这两个指标。
实测架构
6 个 Web Pod 通过 Kubernetes Service 将请求转发给 24 个 API Pod。每个 API 返回自己的 Pod 名。节点上的客户端请求 Web Service 的 ClusterIP。只有状态码为 200 且响应正文包含 API Pod 名才计为成功。
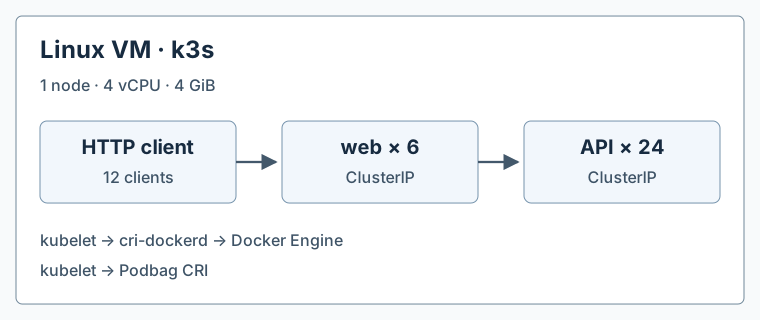
两层使用同一个 NGINX 镜像和 HTTP 就绪探针。每个容器申请 20m CPU 和 16 MiB 内存,上限为 200m 和 48 MiB。k3s 通过内置 cri-dockerd 连接 Docker Engine,通过原生 CRI 套接字连接 Podbag。
Ubuntu 26.04.1 LTS · Linux 7.0.0-43-generic · ARM64 · 4 vCPU · 4 GiB · k3s v1.37.2+k3s1 · Docker Engine 29.1.3 · Podbag c0ff5eb
测量结果
测量数据表
| 指标 | Docker Engine | Podbag |
|---|---|---|
| 30 个 Pod 全部就绪 | 3.39 s | 2.48 s |
| 固定负载 HTTP p95 | 1.41 ms | 1.26 ms |
| 突发负载 HTTP p95 | 3.46 ms | 3.69 ms |
| 突发负载每秒成功响应数 | 7,019 | 6,330 |
| 通过验证的响应 | 33,600 / 33,600 | 33,600 / 33,600 |
在该节点上,Podbag 的就绪时间中位数缩短了 0.91 秒。每秒 240 个请求时,各轮 p95 的范围为 Docker 1.20–1.60 ms,Podbag 0.93–1.88 ms。每轮都收到了全部 24 个 API Pod 的响应。 短时突发负载下,Docker 的吞吐量中位数较高。两者各轮吞吐量的范围有重叠。
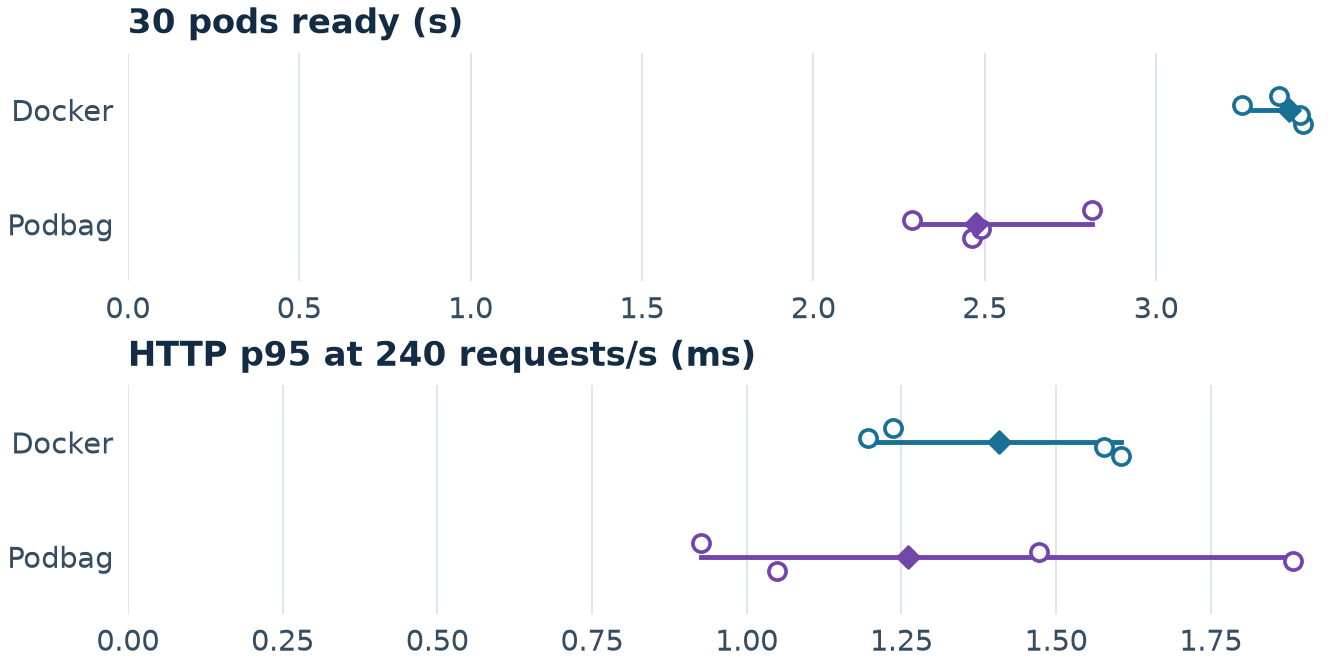
在发出第一个扩容请求前开始计时,每 100 毫秒检查一次,直到两个 Deployment 共报告 30 个副本就绪。随后确认 30 个就绪端点,再等待两秒。12 个客户端各发送 100 个请求,每次使用新的 TCP 连接。p95 表示 95% 的成功请求在该时间内完成。
突发阶段结束后等待两秒,再由同样的 12 个客户端各以每秒 20 个请求的速率运行约 30 秒,总目标为每秒 240 次。两个阶段分别计算 p95。
顺序为 Docker → Podbag → Podbag → Docker。每组预热一次,再测两次。表中数值为每种运行时四次测量的中位数,成功响应数取四次之和。镜像已缓存。客户端与服务共用虚拟机的 CPU。API 只返回简短文本,未测量数据库操作和外部网络延迟。
这些数字描述单节点部署和 HTTP 响应。突发吞吐量也受客户端和网络影响。突发阶段太短,无法估算持续最大吞吐量。
镜像引用为什么会影响结果
预实验使用 NGINX 多架构索引和 IfNotPresent。Podbag 已存储 ARM64 镜像,但 CRI 按索引摘要查找时未命中。kubelet 重试拉取并触发拉取限速。正式测量前,我们在两端验证 ARM64 清单摘要,并使用 imagePullPolicy: Never。每组测量前重启虚拟机并新建集群。
AWS 部署示例
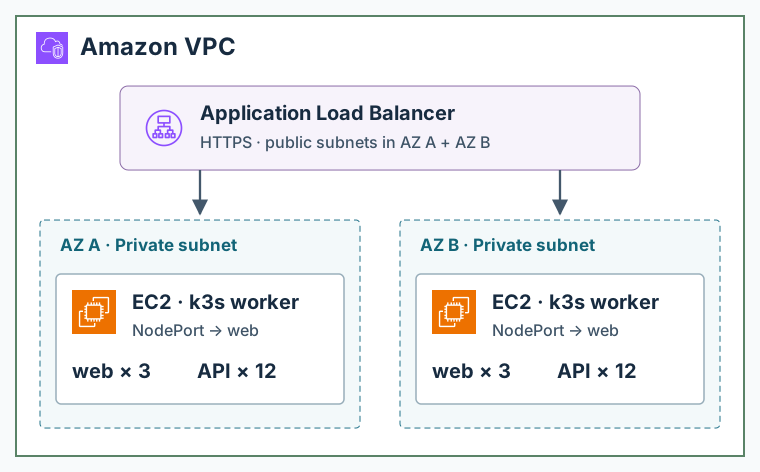
面向互联网的 Application Load Balancer 跨两个可用区的公有子网分发流量。HTTPS 流量转发至私有子网中 EC2 工作节点上的 Web Service NodePort。对每个 Deployment 设置可用区拓扑分布约束,让每个区运行 3 个 Web 和 12 个 API 副本。API Service 通过内部 ClusterIP 提供服务。图中显示的是应用流量路径。
AWS Application Load Balancer · AWS Architecture Icons
复现资料
工作负载 · 测量脚本 · 逐次测量数据 · 节点配置和运行顺序 · start-node.sh