Docker và Podbag trên k3s với 30 pod web
Tác giả: 
 @SteelCrabngày Chuyên mục: Đo hiệu năng, Kỹ thuậtLiên kết cố định
Mất bao lâu để ứng dụng sẵn sàng nhận yêu cầu? Khi hệ thống đã chạy, việc chọn runtime có còn ảnh hưởng đến thời gian phản hồi? Chúng tôi chạy cùng một ứng dụng trên một nút k3s và lần lượt thay runtime.
Cấu hình đo
Sáu pod web chuyển yêu cầu đến 24 pod API qua một Kubernetes Service. Mỗi API trả về tên pod của chính nó. Máy khách trên nút gọi ClusterIP của Service web. Yêu cầu chỉ được tính là thành công khi mã trạng thái là 200 và nội dung là tên một pod API.
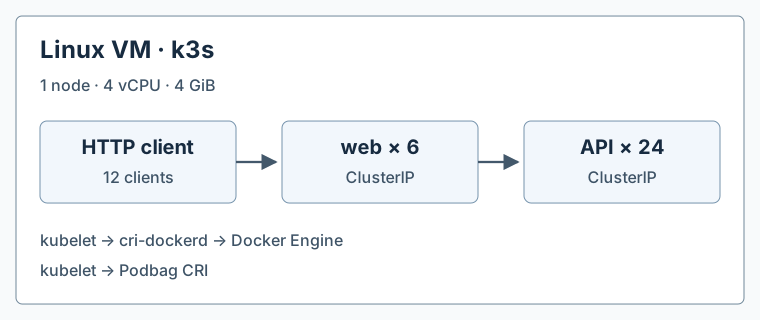
Hai tầng dùng cùng ảnh NGINX và đầu dò HTTP để kiểm tra trạng thái sẵn sàng. Mỗi container yêu cầu 20m CPU và 16 MiB bộ nhớ, với giới hạn 200m và 48 MiB. K3s kết nối với Docker Engine qua cri-dockerd tích hợp sẵn và kết nối với Podbag qua socket CRI của Podbag.
Ubuntu 26.04.1 LTS · Linux 7.0.0-43-generic · ARM64 · 4 vCPU · 4 GiB · k3s v1.37.2+k3s1 · Docker Engine 29.1.3 · Podbag c0ff5eb
Kết quả
Bảng số liệu
| Chỉ số | Docker Engine | Podbag |
|---|---|---|
| Cả 30 pod sẵn sàng | 3,39 s | 2,48 s |
| HTTP p95 ở tải cố định | 1,41 ms | 1,26 ms |
| HTTP p95 khi tải dồn | 3,46 ms | 3,69 ms |
| Yêu cầu thành công/giây khi tải dồn | 7.019 | 6.330 |
| Phản hồi đã xác minh | 33.600 / 33.600 | 33.600 / 33.600 |
Trên nút này, trung vị thời gian triển khai của Podbag thấp hơn 0,91 giây. Ở mức 240 yêu cầu mỗi giây, p95 theo từng lần đo là 1,20–1,60 ms với Docker và 0,93–1,88 ms với Podbag. Cả 24 pod API đều trả lời trong mỗi lần đo. Trong đợt tải dồn, Docker có trung vị thông lượng cao hơn. Khoảng thông lượng giữa các lần đo của hai runtime chồng lấn.
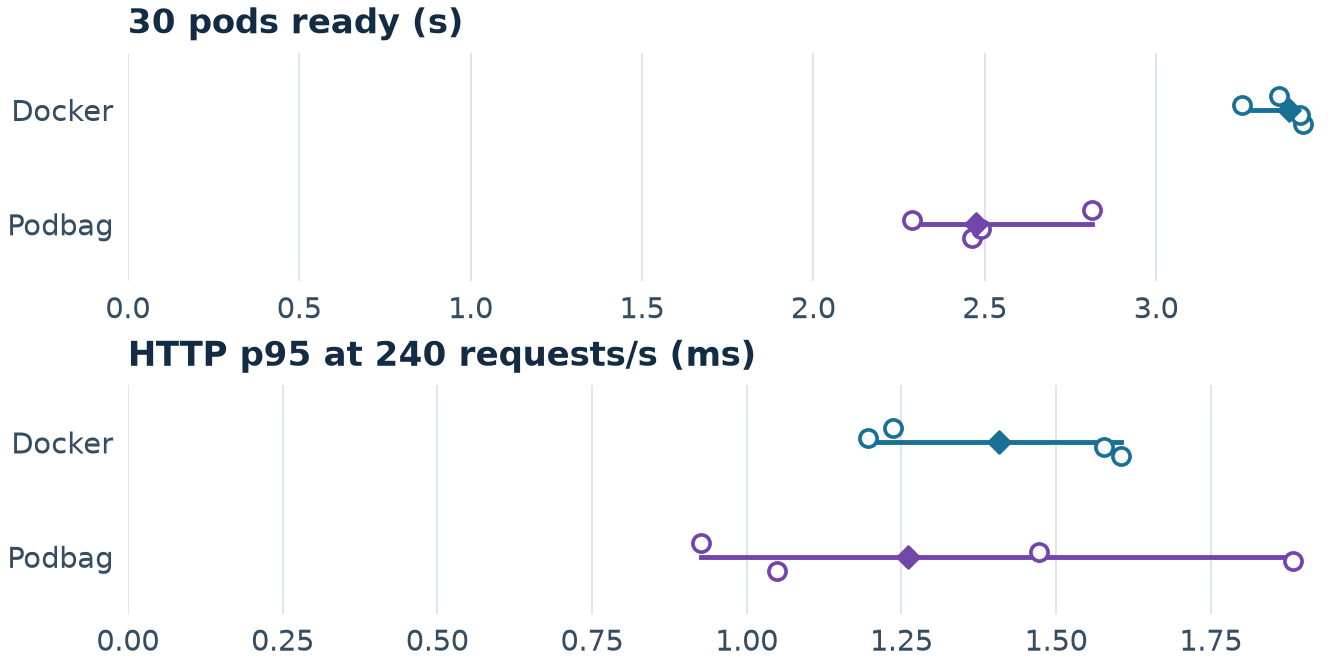
Bắt đầu tính giờ ngay trước yêu cầu tăng số bản sao đầu tiên. Cứ 100 ms chúng tôi kiểm tra hai Deployment cho tới khi đủ 30 bản sao sẵn sàng. Sau khi xác minh 30 endpoint sẵn sàng, chúng tôi đợi hai giây. Mỗi máy khách trong số 12 máy gửi 100 yêu cầu, mỗi lần mở kết nối TCP mới. p95 là thời gian để hoàn thành 95% yêu cầu thành công.
Sau đợt tải dồn, chúng tôi đợi hai giây. Sau đó 12 máy khách gửi 20 yêu cầu mỗi giây mỗi máy trong khoảng 30 giây, với mục tiêu tổng cộng 240 yêu cầu mỗi giây. Chúng tôi tính p95 riêng cho từng giai đoạn.
Thứ tự chạy là Docker → Podbag → Podbag → Docker. Mỗi khối có một lần làm nóng và hai lần đo. Bảng ghi trung vị của bốn lần đo cho mỗi runtime và tổng số phản hồi thành công. Ảnh đã có trong bộ nhớ đệm. Máy khách dùng chung CPU của máy ảo. API chỉ trả về một chuỗi ngắn. Phép đo không bao gồm truy vấn cơ sở dữ liệu và độ trễ mạng bên ngoài.
Số liệu mô tả việc triển khai và phục vụ HTTP trên một nút. Máy khách và mạng đều ảnh hưởng tới tốc độ khi tải dồn. Giai đoạn này quá ngắn để ước tính thông lượng tối đa duy trì được.
Vì sao cách tham chiếu ảnh lại quan trọng
Trong lần thử ban đầu với chỉ mục NGINX đa kiến trúc và IfNotPresent, Podbag đã lưu ảnh ARM64 nhưng CRI không tìm thấy khi tra bằng digest của chỉ mục. Kubelet thử kéo lại và chạm giới hạn tốc độ. Khi đo, chúng tôi xác minh digest của manifest ARM64 trên cả hai engine và dùng imagePullPolicy: Never. Trước mỗi khối, chúng tôi khởi động lại VM và tạo một cụm mới.
Ví dụ triển khai trên AWS
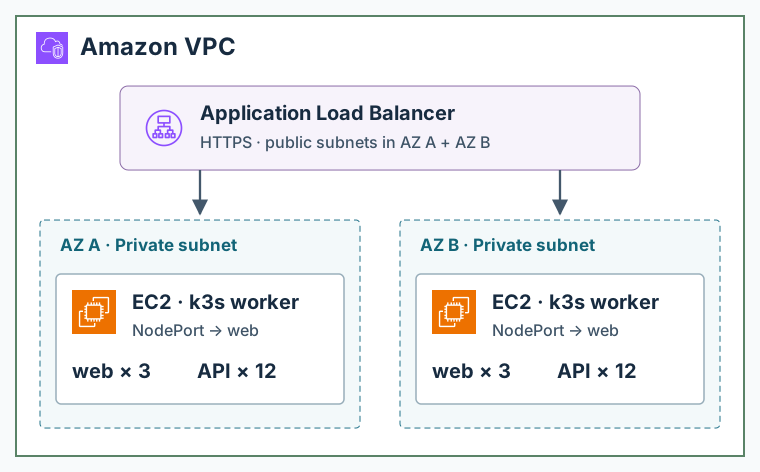
Một Application Load Balancer công khai trải trên hai mạng con công cộng ở hai Vùng sẵn sàng. Lưu lượng HTTPS được chuyển đến NodePort của Service web trên các nút EC2 trong mạng con riêng. Đặt ràng buộc phân bố theo vùng cho mỗi Deployment để mỗi vùng có ba bản sao web và mười hai bản sao API. API dùng Service nội bộ loại ClusterIP. Sơ đồ mô tả đường đi của lưu lượng ứng dụng.
AWS Application Load Balancer · AWS Architecture Icons
Tái hiện phép đo
Workload · Mã đo · Dữ liệu từng lần chạy · Cấu hình nút và thứ tự chạy · start-node.sh